Короткий ответ: сначала выбирайте объём видеопамяти, потом её пропускную способность и только после этого вычислительную мощность. Модель, которая не влезла в VRAM, либо не запустится, либо уйдёт частично в оперативную память и замедлится в разы. Карта на 30% медленнее, но с 24 ГБ вместо 16 ГБ запустит то, что быстрая карта не запустит совсем.
Почему в ИИ гигабайты решают больше, чем терафлопсы
В играх видеокарта постоянно считает: геометрию, освещение, постобработку. В языковых моделях основная работа устроена иначе. На каждый сгенерированный токен карта прочитывает из памяти почти все веса модели. Вычислений в этой операции немного, зато данных очень много. Большую часть времени ядра ждут, пока память отдаст следующую порцию.
Отсюда простое правило. Пока модель целиком лежит в VRAM, работа идёт быстро. Как только часть слоёв выгружается в системную ОЗУ, скорость определяет шина PCIe и оперативная память, а они в разы медленнее видеопамяти. Генерация, которая шла бодро, превращается в ожидание каждого слова.
Терафлопсы заметны в другом: при обработке длинного промпта, генерации изображений и обучении. Там считать действительно приходится много. Но и здесь объём задаёт потолок: размер модели, разрешение картинки, длину контекста и размер батча при дообучении.
Пропускная способность: за что вы платите кроме объёма
Две карты с одинаковыми 16 ГБ могут отличаться по скорости в языковых моделях почти вдвое. Причина в ширине шины и типе памяти. Для оценки на глаз есть грубая формула: теоретический потолок скорости генерации примерно равен пропускной способности, делённой на размер модели в памяти. Модель на 18 ГБ на карте с полосой около 1 ТБ/с даст потолок порядка нескольких десятков токенов в секунду. На практике выходит заметно меньше, но соотношение между картами формула передаёт верно.
| Видеокарта | VRAM | Шина | Пропускная способность |
|---|---|---|---|
| RTX 4060 Ti 16 ГБ | 16 ГБ GDDR6 | 128 бит | 288 ГБ/с |
| RTX 5060 Ti 16 ГБ | 16 ГБ GDDR7 | 128 бит | 448 ГБ/с |
| RTX 5070 Ti | 16 ГБ GDDR7 | 256 бит | 896 ГБ/с |
| RTX 5080 | 16 ГБ GDDR7 | 256 бит | 960 ГБ/с |
| RTX 3090 | 24 ГБ GDDR6X | 384 бит | 936 ГБ/с |
| RTX 4090 | 24 ГБ GDDR6X | 384 бит | 1008 ГБ/с |
| Radeon RX 7900 XTX | 24 ГБ GDDR6 | 384 бит | 960 ГБ/с |
| RTX 5090 | 32 ГБ GDDR7 | 512 бит | 1792 ГБ/с |
Из таблицы видно, почему RTX 3090 до сих пор востребована: по полосе она на уровне RTX 5080, а памяти у неё в полтора раза больше. И почему RTX 4060 Ti 16 ГБ разочаровывает в языковых моделях: объём есть, а узкая шина ограничивает скорость.
Граница 16 ГБ: что перестаёт влезать в 2026 году
16 ГБ хватает на многое: языковые модели до 14 миллиардов параметров с запасом под контекст, генерацию изображений на SDXL, обучение LoRA для неё. Подробный разбор, какие модели в какой объём помещаются, есть в статье «ПК для локального ИИ: сколько VRAM нужно». Здесь важнее другое: где 16 ГБ начинают мешать при покупке на несколько лет вперёд.
- Языковые модели класса 27–32B. Это популярный «средний» размер у открытых моделей. В 4-битной квантизации им нужно порядка 16–20 ГБ только под веса, плюс память под контекст. В 16 ГБ они либо не влезают, либо требуют агрессивного сжатия с потерей качества.
- Длинный контекст. Кэш контекста растёт с длиной диалога или документа. Модель, которая запустилась с коротким промптом, может упереться в память на длинном.
- Flux и похожие модели изображений. Полные версии рассчитаны на 24 ГБ. На 16 ГБ они работают через квантизованные варианты и выгрузку частей, медленнее и с компромиссами.
- Генерация видео. Локальные видеомодели крупного размера ощутимо требовательнее к памяти, на 16 ГБ доступны в основном облегчённые версии.
- Дообучение. LoRA для крупных моделей изображений и текста комфортно делать от 24 ГБ.
Модели не становятся компактнее с каждым поколением, скорее наоборот. Если вы собираетесь заниматься ИИ всерьёз, 16 ГБ в 2026 году стоит считать входным уровнем, а не запасом.
24 и 32 ГБ: какие карты реально существуют
Выбор в потребительском сегменте узкий, и это стоит знать заранее.
RTX 3090 и 3090 Ti, 24 ГБ
Сняты с производства, продаются в основном на вторичном рынке. Самый дешёвый способ получить 24 ГБ с CUDA. Минусы: возраст, неизвестная история (многие карты работали в майнинге), горячая память на обратной стороне платы у 3090, потребление около 350 Вт. Перед покупкой стоит проверить температуру памяти под нагрузкой и состояние термопрокладок.
RTX 4090, 24 ГБ
Тоже ушла из производства, новые экземпляры встречаются всё реже, цена держится высоко. Заметно быстрее 3090 в генерации изображений и обучении, в языковых моделях разница меньше: полоса почти та же. Потребление до 450 Вт.
RTX 5090, 32 ГБ
Единственная актуальная потребительская карта NVIDIA с объёмом больше 24 ГБ и самой широкой полосой в классе. Лишние 8 ГБ открывают модели 32B с длинным контекстом и запас под видео. Цена флагманская, потребление до 575 Вт, нужен качественный блок питания мощностью порядка 1000 Вт и корпус с хорошим продувом.
Radeon RX 7900 XTX и Radeon AI PRO R9700
У AMD 24 ГБ в RX 7900 XTX и 32 ГБ в профессиональной R9700. За гигабайт выходит дешевле, чем у NVIDIA, но есть программные оговорки, о них ниже.
Выше начинаются профессиональные карты с 48 ГБ и больше (линейки RTX A6000, RTX 6000 Ada, RTX PRO 6000). Их цена в разы выше потребительских, и смысл они имеют для студий и команд. Такие карты обычно ставят в рабочие станции с расчётом на круглосуточную нагрузку. Конкретные цены не приводим: на момент чтения они почти наверняка изменились.
CUDA, ROCm и драйверы: почему зелёные карты проще
Почти весь софт для локального ИИ пишется и тестируется в первую очередь под CUDA. Инструкция к новому инструменту на GitHub почти всегда начинается с NVIDIA, а поддержка остальных появляется позже или силами сообщества.
- NVIDIA. Работает из коробки в Windows и Linux: llama.cpp, Ollama, LM Studio, ComfyUI, PyTorch, инструменты для обучения. Проблемы решаются поиском по тексту ошибки.
- AMD. ROCm поддерживает старшие Radeon, лучше всего под Linux. Языковые модели через llama.cpp и Ollama работают нормально, в том числе через Vulkan. Сложнее с генерацией изображений и обучением: часть расширений и оптимизаций есть только под CUDA, иногда приходится ждать обновлений или собирать что-то вручную.
- Intel Arc. Дешёвый вход, но объёмы небольшие, а экосистема ещё уже, чем у AMD.
Практический вывод: если хотите просто пользоваться и не разбираться в сборке библиотек, берите NVIDIA. Radeon с 24–32 ГБ имеет смысл, если вы готовы работать в Linux и вам в основном нужны текстовые модели.
Одна большая карта или две маленькие
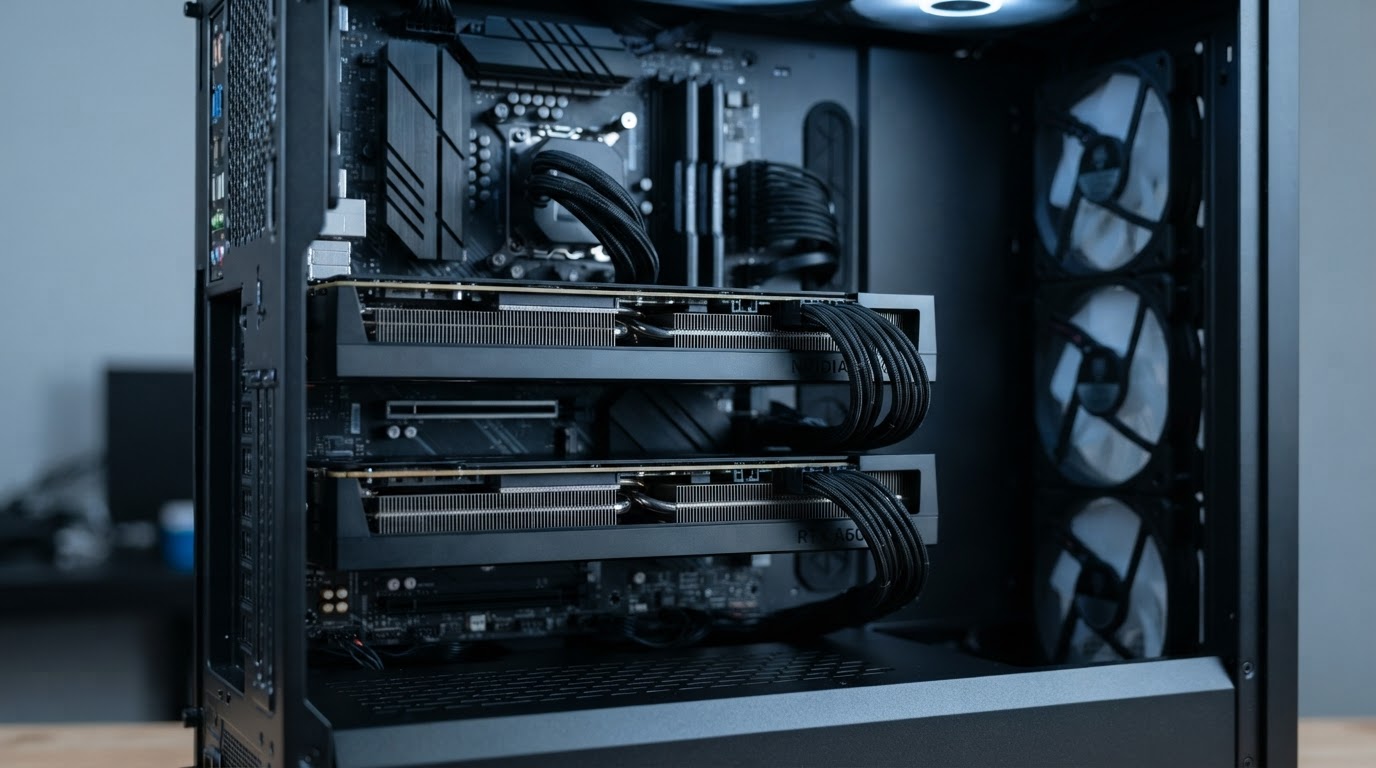
Идея поставить две карты по 16 ГБ вместо одной на 32 ГБ выглядит экономной. Работает она только частично.
- Языковые модели делятся хорошо. llama.cpp, Ollama и vLLM раскладывают слои по нескольким картам, объём фактически суммируется. Скорость при этом не удваивается: карты по очереди обрабатывают свои слои.
- Генерация изображений делится плохо. Одну модель Flux или SDXL на две карты обычно не разложить. Вторая карта пригодится разве что для параллельной очереди или под текстовый энкодер.
- Железо дорожает. Нужна материнская плата с двумя слотами на нормальном расстоянии и достаточным числом линий PCIe, блок питания с запасом, корпус с продувом. У RTX 4090 и 5090 нет NVLink, связь идёт через PCIe.
Две подержанные RTX 3090 дают 48 ГБ под текстовые модели за сумму, сопоставимую с одной новой флагманской картой. Это рабочий вариант для энтузиастов, но шумный, горячий и требующий продуманной сборки. Для остальных одна карта с максимальным объёмом проще и надёжнее.
Три покупки под три бюджета
| Бюджет | Карта | Что получаете | Компромисс |
|---|---|---|---|
| Начальный | RTX 5060 Ti 16 ГБ | Модели до 14B, SDXL, Flux в сжатом виде | Узкая шина, модели 27–32B не влезают |
| Средний | RTX 3090 24 ГБ с рук или RTX 5070 Ti 16 ГБ | 3090: модели до 32B в 4 битах, полный Flux. 5070 Ti: скорость и гарантия | 3090: возраст и риски вторичного рынка. 5070 Ti: те же 16 ГБ |
| Высокий | RTX 5090 32 ГБ | Модели 32B с длинным контекстом, видео, обучение LoRA | Цена, потребление, требования к БП и корпусу |
Если компьютер нужен и для игр, и для нейросетей, баланс другой: в играх 16 ГБ хватает с запасом, и RTX 5070 Ti или 5080 будет разумнее старой 3090. Подобрать игровую конфигурацию под свои задачи можно в подборщике игровых ПК. Как сбалансировать процессор, ОЗУ и накопитель под ИИ, мы разбирали в материале «ПК для нейросетей»: оперативной памяти стоит ставить не меньше, чем видеопамяти, а лучше вдвое больше.
Когда видеокарта не нужна: аренда против своего железа
Облачные GPU сдаются почасово, включая карты на 48 и 80 ГБ, которые дома ставить бессмысленно. Аренда выгоднее, если:
- вы пробуете ИИ несколько часов в месяц и ещё не знаете, понравится ли;
- нужно разово дообучить большую модель, которая не влезет ни в одну домашнюю карту;
- задача сезонная, а не ежедневная.
Своё железо выигрывает при регулярной работе: каждый день, с собственными данными, без загрузки файлов на чужие серверы и без очереди за свободными картами. Простой ориентир: посчитайте, сколько часов в месяц вы реально будете нагружать карту, умножьте на стоимость аренды сопоставимого GPU и сравните со стоимостью карты за два-три года её службы.
Коротко
- Объём видеопамяти определяет, что вообще запустится; скорость вычислений важна во вторую очередь.
- Пропускная способность памяти задаёт скорость генерации текста: смотрите на шину, а не только на гигабайты.
- 16 ГБ в 2026 году хватает на старт, для моделей 27–32B и полного Flux нужно 24 ГБ.
- Реальные варианты с 24–32 ГБ: RTX 3090, 4090, 5090 и старшие Radeon; NVIDIA проще в настройке.
- Если нагрузка редкая, арендуйте GPU; если ежедневная, своя карта окупается.